游戏服务器中消息是如何传递的
消息协议与传输【msg_id篇】
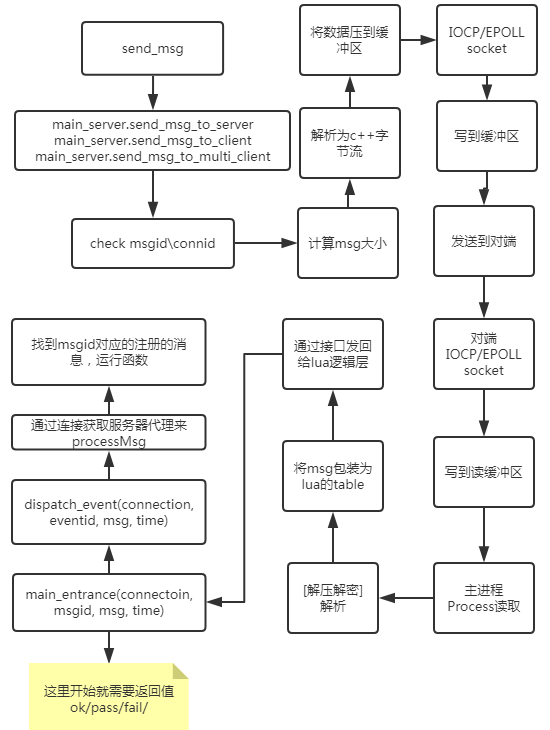
消息流程图解
消息定义与数据类型
消息定义
消息定义+消息结构定义,能让底层传输的数据仅仅只有数据,而没有数据类型、名字、分类。两边通过消息id来区分该消息的结构,一边压缩,一边解析。极大的减少了传输的数据量。
const常量表
定义一些在之后的消息定义中会使用到的常量。比如GS的最大数量、密码的长度、角色名的长度。
角色事件
定义玩家的一些操作事件,这里的操作包括了在服务器中流转的消息和在客户端内玩家操作需要服务器进一步处理的消息。
角色使用物品事件
确认取消框
服务器通过传送这类消息来让客户端显示某种类型的按钮显示框,客户端接收到这类消息后会自动将用户的选择结果返回给服务器。
服务器与服务器之间的公共消息
这类的消息是最多的,一般会用是哪两种服务器之间的通信进行定义消息分类名。
通用消息
一些事件可能是临时加的、或者是非常特殊的消息,或者是所有服务器都能使用的公用消息。这类的消息分类不明显,可以放到通用消息结构内。但是这类消息应注意不要和其他类型的消息值冲突在判定消息时可能会引起错误。
各类消息结构定义
lua到c++传输数据转换
消息的转换过程
消息注册
lua层定义的消息有一个格式,列表中{msgid, base, defstring} 对应了某个msgid应该对应的解析字符串是什么。当然每个进程的c++会将对应的服务器之间的消息保存到对相应的数据内存中。python伪代码如下
1
2
3
4
5
6
7
8
9
10
11
# c++存储对应表的变量 vector<vector<pair<string, FieldValue*>>>
def register_all_common_for_process():
	for r_defin all_def:
	       	main_server.register_type(r_def.id, r_def.def)

# c++层进行注册
class main_server():
	def register_type(self, id, defstr):
		if not check_exist(id):
					add_new_msg(id, defstr)# 对defstr字符串进行解析,保存到对应的解析字段类中
消息转换
每一个lua消息需要发送的时候,msgid是关键,每个msgid对应的数据串的结构。假设有个服务器需要发送某个msgid值的msg_table到另一个服务器。
消息判断。首先判断一下当前的msgid是否存在。
获取用msgid来解析msg_table,将其转换为单纯的c++数据字符串,用递归重复的判断数据。python伪代码如下:
plain text 通过这样一层一层每一种数据,读取固定的数据,将其转化为固定长度。整个消息结构遍历完毕后,就能得到整个retbuffer字符串,这个字符串中存的全部是数据,没有多余的名字等字段。
在上一步完成后,现在有的数据就是需要传输的数据的msg实体与这个msg的长度
然后,在写到输出缓冲区时,还需要包装上msgid和连接id,一条完整的消息结构如下:
然后就可以发送了。但是不同的地方是这里的数据没有压缩,也没有加密。那么如果有很长的数据,会进行压缩。而有的数据也需要进行加密。以下我们继续介绍这两部分。
消息压缩
数据过长也就是字符串过长,压缩的方法有很多种,压缩的效率和压缩的效果成反比,常用的有 LZ77 和 LZ4 压缩算法。现在的服务器使用的是LZ4算法中的快速版本。总而言之,这两个算法就是是字典查重复字符串,在用滑动窗口的情况下,记录位置长度。
LZ77 压缩算法是当今最常用的无损压缩算法,是基于字典的带滑动窗口的。
- LZ77 压缩算法的原理 微软LZ77文档
假设有一串字符串AABCBBABC,当前这个字符串的长度为9。假设我们读到了第二个字符A,此时程序会记录 (1,1) 代表了距离上一个字符串距离为1,字符的长度为1。而如果读到了第二个B,那么值就会是(2,1) 。
这样做的话有个问题,对于刚刚的列子来说,串中只有3个字符,存的字典中可能就只有3个。而如果字符数很多,匹配的字符串长度不一定为1的话,这个字典就会非常大。那么匹配一个字符串是否是字典中出现的时候复杂的会异常的高。
LZ77引入了搜索缓冲区和待检查区。搜索缓冲区代表的是字典字符串,负责的是被检查串的匹配对象。待检查缓冲区代表的是检查窗口,这个窗口当然是滑动的。这也保证了每次LZ77匹配的时候不会匹配过多的字符串导致复杂度急剧上升。
- LZ77 压缩算法模拟
此时待编码区有“ABC”。开始编码。最先编码”A”,在搜索区找到”A”。由于没有超过待编码区,故开始编码”AB”,但在搜索区没有找到匹配字符串,故无法编码。因此只能编码”A”。
输出(1, 1)。即为相对于待编码区,偏移一个单位,匹配长度为1。窗口右滑动匹配长度,即移动1个单位。如下图
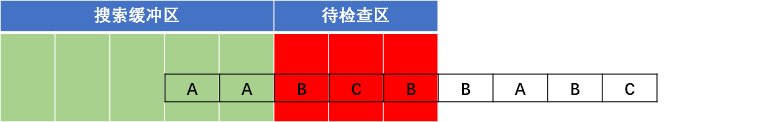
一样,没找到,输出(0, 0, B),右移1个单号,如下图
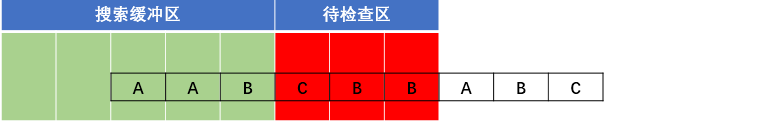
输出(0, 0, C),右移1个单位,如下图

输出(2, 1),右移1个单位,如下图
输出(3, 1), 右移1个单位,如下图
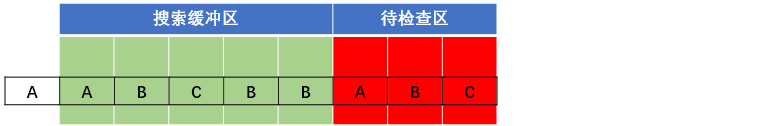
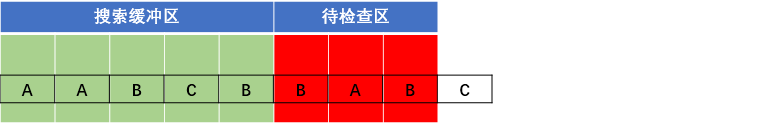
开始编码”A”,在搜索缓冲区查找到匹配字符串。由于待编码缓冲区没有超过,继续编码。开始编码”AB”,也搜索到。不要停止,继续编码“ABC”,找到匹配字符串。由于继续编码,则超过了窗口,故只编码“ABC”,输出(5, 3),偏移5,长度3。右移3个单位,如下图
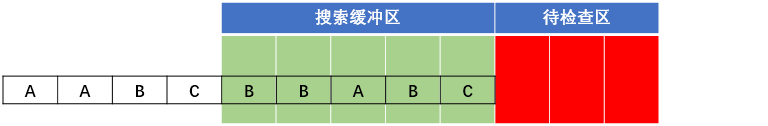
此时待编码缓冲区为空,停止编码。
- 字符串的匹配算法 - KMP
LZ4是基于LZ77的基础上修改了一些实现方法和存储表使用空间,简化了,但是变得非常的快。
LZ4 压缩算法原理
LZ4 压缩算法图解
消息加密
Client到BCS的数据有些数据类型是需要加密传输的,比如最简单的例子:密码。但是密码加密可以用不可逆算法MD5处理,而有的数据类型需要通过解密得到其中的数据。
密钥和公钥
消息传输
io模型
unix下有以下5中io模型。
blocking IO - 阻塞IO
nonblocking IO - 非阻塞IO
IO multiplexing - IO多路复用
signal driven IO - 信号驱动IO
asynchronous IO - 异步IO
“真正”的异步IO需要操作系统更强的支持。在IO多路复用模型中,事件循环将文件句柄的状态事件通知给用户线程,由用户线程自行读取数据、处理数据。而在异步IO模型中,当用户线程收到通知时,数据已经被内核读取完毕,并放在了用户线程指定的缓冲区内,内核在IO完成后通知用户线程直接使用即可。
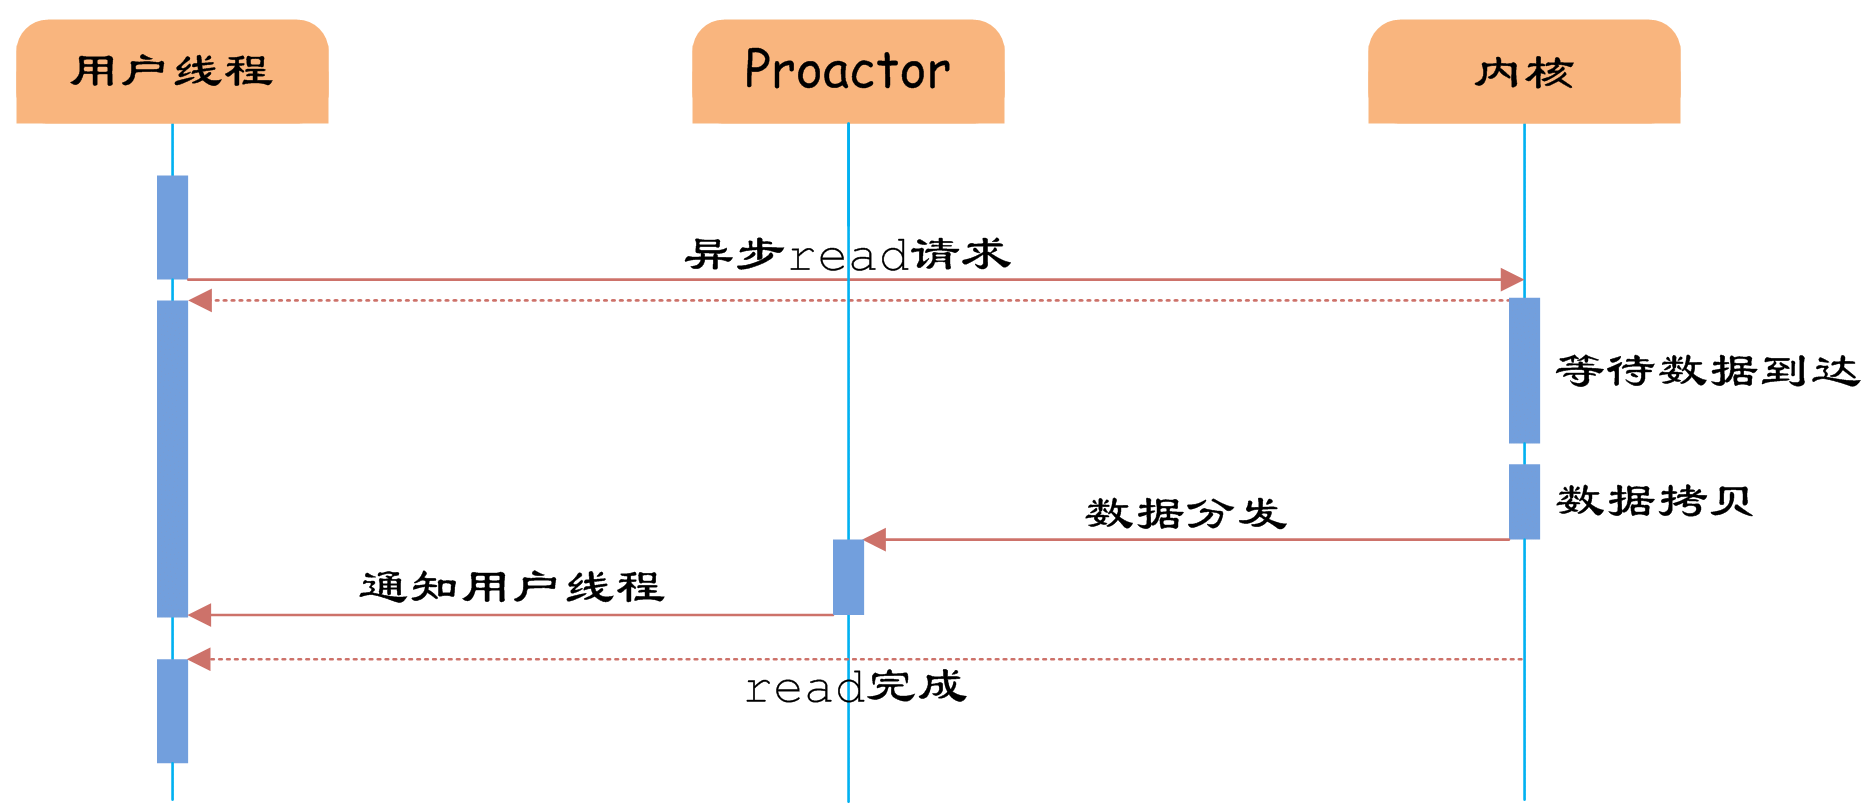
相比于IO多路复用模型,异步IO并不十分常用,不少高性能并发服务程序使用IO多路复用模型+多线程任务处理的架构基本可以满足需求。况且目前操作系统对异步IO的支持并非特别完善,更多的是采用IO多路复用模型模拟异步IO的方式(IO事件触发时不直接通知用户线程,而是将数据读写完毕后放到用户指定的缓冲区中)。Java7之后已经支持了异步IO,感兴趣的读者可以尝试使用。
其中前面4种IO都可以归类为同步IO,而select、poll、epoll本质上也都是同步I/O,因为他们都需要在读写事件就绪后自己负责进行读写,也就是说这个读写过程是阻塞的。
epoll与IOCP
epoll和IOCP都是作为IO复用的代表,在单线程下能进行多个IO的同时监听,相较于select/poll来说,他们复杂度更加优秀。epoll是linux独有的,而IOCP则是用在windows下的。这里我介绍以下epoll。
epoll原理
说起epoll就需要简单说一下io问题。我们在socket读取数据的时候,socket.accept()函数会一直阻塞,直到有新的数据到来,底层cpu会同时用户可以进行接收数据了。很明显,如果让进程一直等在这里阻塞,就浪费了大量的事件,况且有的服务器会连接多个服务器,那处理完一遍所有服务器的请求,时间就是服务器个数*处理时间 + 阻塞时间。这里我们假设的是在处理一个数据的时候,其他数据都到来了。
select解决的是在同一时间监听多个io,并且能自己设置等待时间。这样我们现在的逻辑就能变成:如果等待一定的时间后都没有数据到来,就跳出来处理其他的东西,而此时,select实际上仍然是在监听是否有数据到来。如果有数据到来,select会将这个socket,或者说是文件描述符标记为可读状态,当然一个io可读同时也可写。
但是select有缺点
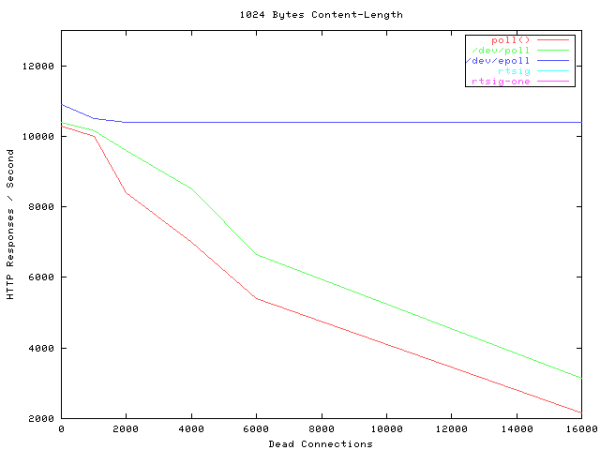
第一点是他监听的io数量有上限,这个上限是1024。poll解决了这个问题。
第二点poll没能解决,每次用户态需要将内核态的数据复制过来,一个一个检查当前这个io是否可以读或者写。这大大降低了select在监听大量io时候的效率。以下是select/poll/epoll在监听io数量上的性能变化:
epoll的快速
第一点是epoll在被内核初始化时,同时会开辟出epoll自己的内核高速cache区,用于安置每一个我们想监控的socket,这些socket会以红黑树的形式保存在内核cache里,以支持快速的查找、插入、删除。
第二点是我们在调用epoll_create时,内核除了帮我们在epoll文件系统里建了个file结点,在内核cache里建了个红黑树用于存储以后epoll_ctl传来的socket外,还会再建立一个list链表,用于存储准备就绪的事件,当epoll_wait调用时,仅仅观察这个list链表里有没有数据即可。有数据就返回,没有数据就sleep,等到timeout时间到后即使链表没数据也返回。
list链表
list链表中的数据是通过内核的中断来写入的。当我们执行epoll_ctl时,除了把socket放到epoll文件系统里file对象对应的红黑树上之外,还会给内核中断处理程序注册一个回调函数,告诉内核,如果这个句柄的中断到了,就把它放到准备就绪list链表里。所以,当一个socket上有数据到了,内核在把网卡上的数据copy到内核中后就来把socket插入到准备就绪链表里了。
红黑树
红黑树是一棵平衡树,但相较于AVL平衡树的完全平衡来说,红黑树的左右两端的平衡差并不一定是一。
总结一下,epoll的高效是建立在一棵红黑树、一个句柄链表、以及少量内核cache上的。
服务器的监听架构

创建监听
在底层,每一个进程都会创建一个epoll监听,再创建一个线程,让线程阻塞地运行epoll进行io的读取。
Create()创建一个新的epoll。
线程运行
创建线程来开始epoll的阻塞等操作,linux下线程创建后会立即运行。线程调用的函数中
Release()判断是否已经退出。等待线程退出,关闭各种套接字、epoll。
读写流
服务器实体和EPOLL层都能作为读者和写者,缓冲区分类为读入、写出两种。m_RBuffer负责接收的数据,m_SRbuffer负责写的数据相当于每个服务器一般对应两类线程,一类专门处理epoll阻塞的io请求, 另一类只有一个,专注处理逻辑处理与分发
读写指针图解
一般情况下,程序运行的时候,在buffer中有读和写两种指针,以下是读缓冲区(也就是从外部程序到本程序的数据):
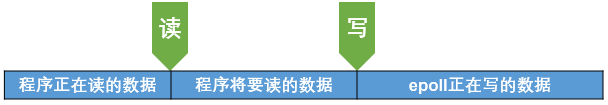
在有新的数据来的时候,epoll会在写指针的后面写东西,但此时并不会动写指针,只有当写的数据写完毕了才原子性地修改写指针的位置。这样能保证读指针读取的数据一定是写好了的。
epoll读取数据的时候,会让buffer申请一个数据块进行写,如果这个数据块正在被读,那么就会重新申请一个。
此时的写端为epoll线程,读端为逻辑处理区,要注意的是不同的服务器连接用的是不同的epoll连接对象,每个对象都会有自己的buffer区,这样保证了不同的buffer区存储的一定都是固定的两个服务器的某个方向的数据。
以下是写缓冲区(也就是从本程序到外部程序的数据):
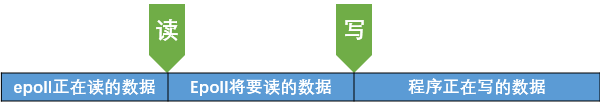
最开始,写出数据中有两个队列。一个buffer队列。其中写的有要发送出去的数据,另一个为请求队列,放的是要发送的客户实例指针。在发送数据的时候,就会s在两个队列中取出数据,将buffer中的数据使用对应的客户端实例的epoll来发送这个数据。